Wie lange dauert die Google-Indexierung?
Am 06.09.2026 standen 109 von 133 Adressen dieser Domain im Google-Index. Am 01.10. war es eine. An den Texten hatte sich dazwischen nichts geändert, an der Domain einiges. Das ist die kurze Antwort auf die Frage im Titel: Wie lange die Indexierung dauert, entscheidet Google nicht je Seite, sondern je Domain, und „indexiert“ ist kein Endzustand. Eine Seite wird entdeckt, abgerufen, aufgenommen und danach weiter bewertet. Jeder dieser Schritte hat seine eigene Wartezeit, seine eigene Meldung in der Search Console und seine eigene Ursache, wenn er ausbleibt. Googles eigene Zahlen sind trotzdem der richtige Anfang.
Was Google an Zeiträumen nennt#
Die Zahlen stehen an drei Stellen der Google-Dokumentation, und sie meinen drei verschiedene Dinge.
Zum Crawling nach einer Anfrage über die URL-Prüfung heißt es: „Das Crawling kann einige Tage oder mehrere Wochen dauern." Das ist die Zeit, bis der Googlebot vorbeikommt, nicht die Zeit bis zur Aufnahme.
Zur Indexierung nach demselben Antrag: „Die Indexierung kann ein bis zwei Wochen dauern", und weiter unten: „Die Indexierung dauert normalerweise nur einen Tag, in manchen Fällen aber auch länger." Der Antrag selbst ist dabei kein Versprechen: „Das Einreichen einer Anfrage garantiert nicht, dass die Seite im Google-Index erscheint."
Zu Änderungen an bestehenden Seiten sagt der SEO-Startleitfaden: „Einige Änderungen werden möglicherweise innerhalb weniger Stunden wirksam, bei anderen kann es mehrere Monate dauern." Als Maßstab fürs Abwarten nennt er: „Generell solltest du einige Wochen warten."
Was Google nirgends nennt, ist eine Zahl für eine neue Seite, die niemand beantragt hat. Das ist der Normalfall, und dafür gibt es nur den Satz aus derselben Doku: Die Systeme priorisieren „die Indexierung qualitativ hochwertiger und nützlicher Inhalte". Die Reihenfolge ist keine Warteschlange nach Eingang.
Drei Schritte, drei Wartezeiten#
Was zwischen Veröffentlichen und Auffindbarkeit passiert, beschreibt Google in „So funktioniert die Google Suche" als Abfolge. Jede Stufe kann die Seite behalten, und für jede Stufe gibt es eine eigene Meldung im Bericht „Seitenindexierung“.
Entdecken. Google muss die Adresse erst kennen. Der Hauptweg ist der Verweis: Seiten werden „entdeckt, wenn Google einen Link von einer bekannten Seite extrahiert, der auf eine neue verweist". Der zweite Weg ist die Sitemap. Wer keinen von beiden bedient, wartet auf Zufall, und die URL-Prüfung sagt „URL ist Google unbekannt“.
Crawlen. Bekannt heißt noch nicht abgerufen. „Der Googlebot bestimmt anhand eines algorithmischen Prozesses, welche Websites wann und wie oft durchsucht und wie viele Seiten von jeder Website abgerufen werden." Er bremst sich selbst, sobald der Server Fehler liefert: „HTTP-Fehler 500 bedeuten ‚langsamer'". Eine Seite in dieser Stufe meldet die Search Console als „Gefunden – zurzeit nicht indexiert": Google „hat normalerweise versucht, die URL zu crawlen, aber das hätte die Website überlastet. Daher hat Google das Crawling neu geplant."
Indexieren. Abgerufen heißt noch nicht aufgenommen. Google sagt das ungewohnt deutlich: „Die Indexierung wird nicht garantiert – es wird also nicht jede Seite, die von Google verarbeitet wird, indexiert." Beim Abruf wird gerendert, JavaScript ausgeführt, die Seite mit Dubletten zu einem Cluster gruppiert und eine kanonische Fassung gewählt. Wer hier hängen bleibt, sieht „Gecrawlt – zurzeit nicht indexiert". Die Seite „könnte jedoch in Zukunft indexiert werden. Sie brauchen diese URL nicht noch einmal zum Crawling einzureichen."
Die Frage „wie lange dauert es" hat also drei Antworten, und die Search Console sagt, in welcher Stufe die Seite gerade steckt. Wie man das nachschlägt, steht unter Die URL-Prüfung der Search Console lesen.
Was die Dauer bestimmt, laut Google#
An erster Stelle Verweise von Seiten, die Google schon crawlt. Der Startleitfaden ist eindeutig: „Google findet Seiten hauptsächlich über Links von anderen bereits gecrawlten Seiten." Eine neue Seite, die nur in der Sitemap steht und nirgends verlinkt ist, hat den langsameren Weg gewählt.
Dann die Sitemap, aber nur mit einem lastmod, das stimmt. Sie „ist für Google wichtig, um URLs auf deiner Website zu ermitteln", aber Google kann „nicht garantieren, dass alle Elemente in deiner Sitemap gecrawlt und indexiert werden". Das Datum darin zählt nur unter einer Bedingung: „Google verwendet den Wert <lastmod>, wenn er konsistent und nachweisbar korrekt ist." Ein lastmod, das bei jedem Bau auf heute springt, ist keins. <priority> und <changefreq> ignoriert Google.
Und schließlich die Crawling-Kapazität des Servers. Das Limit sinkt, wenn „die Latenz steigt oder die Antwortzeiten länger werden", und bei Fehlern oder Ratenbegrenzung wie HTTP 429. Der Bedarf steigt mit Beliebtheit: „URLs, die im Internet beliebter sind, werden tendenziell häufiger gecrawlt." Googles Leitfaden zum Crawling-Budget richtet sich allerdings an Websites ab 10.000 Seiten mit täglichen Änderungen. Wer zweihundert Seiten hat, ist nicht die Zielgruppe. Was die Frequenz sonst bestimmt, steht weiter unten.
Fünf Schritte, bevor du wartest#
Der technische Teil dauert eine Viertelstunde.
- Prüfen, ob die Seite aufnahmefähig ist. Liefert sie
200? Steht einnoindexim Quelltext oder imX-Robots-Tag? Zeigt dascanonicalauf sich selbst? Sperrt dierobots.txtden Pfad? Das SEO-Audit prüft dasnoindexim Quelltext, den Canonical, dierobots.txtund das Vorhandensein der Sitemap in einem Durchgang. Eine Adresse, die hier durchfällt, wird nie indexiert, egal wie lange man wartet. - Von einer Seite verlinken, die Google schon regelmäßig abruft. Startseite, Rubrikübersicht, ein gut besuchter Beitrag. Das ist Googles Hauptweg der Entdeckung, und er kostet kein Kontingent.
- Die Sitemap aktuell halten und einmal einreichen. Mit einem
lastmod, das nur bei echten Änderungen springt. Für zehn neue Seiten ist das der richtige Weg, nicht der Einzelantrag. Google selbst sagt: „Wenn Sie viele Seiten indexieren möchten, reichen Sie eine Sitemap bei Google ein." - Einzeln beantragen nur, wenn es auf Stunden ankommt. Eine Korrektur, ein versehentliches
noindex, eine Weiterleitung nach dem Umzug. Das Kontingent ist klein und gilt kontoweit. - Nach zwei Wochen nachsehen, nicht nach zwei Tagen. In der URL-Prüfung, und dort nicht nur auf den Status, sondern auf das Datum des letzten Crawls. Steht dort keins, ist die Seite noch nicht entdeckt, und die Maßnahme heißt Verweise. Steht ein Datum und der Status ist „Gecrawlt – zurzeit nicht indexiert", ist die Maßnahme eine andere.
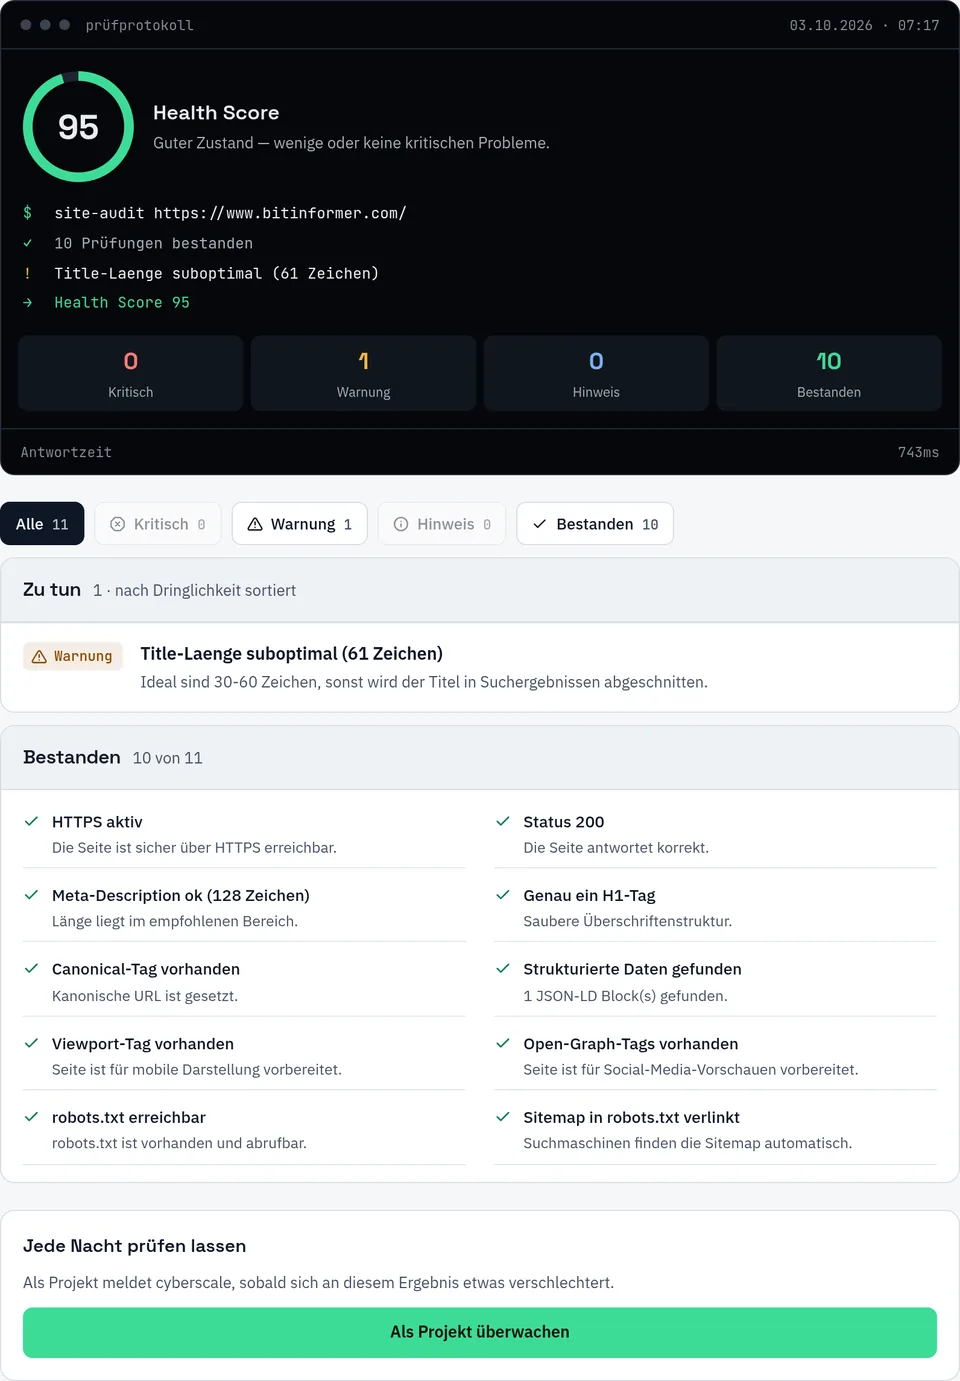
So sieht Schritt 1 mit dem eigenen Werkzeug aus, hier für die Startseite von bitinformer.com (eine eigene Seite) am 03.10.2026: Canonical, robots.txt, Sitemap und Statuscode sind in Ordnung, nur der Titel ist mit 61 Zeichen eine Spur zu lang. Eine Seite, die hier bei Canonical oder Status durchfällt, braucht keine Wartezeit, sondern eine Korrektur.
Was ich an der eigenen Domain gesehen habe#
In eigener Sache: cyberscale.io ist die Domain dieses Magazins, und sie ist seit September ein Lehrstück dafür, dass „indexiert“ kein Endzustand ist. Alle Zahlen stammen aus der URL-Inspection-API der Search Console, jeweils über sämtliche Adressen der damals gültigen Sitemap, nicht aus Stichproben.
Am 06.09.2026 standen abends 109 von 133 Adressen im Index. Zwei Tage vorher hatte der Bericht „Seitenindexierung“ 44 Seiten als „Gecrawlt – zurzeit nicht indexiert“ geführt, am 05.09. waren es 170, am 21.09. noch 173. In derselben Zeit habe ich die Seite umgebaut: alte Beiträge umgeleitet, Dutzende auf noindex gesetzt, die Sitemap von 134 auf 73 und dann auf 39 Adressen gekürzt. Am 01.10. war von 73 Adressen eine indexiert, die Startseite. 57 waren gecrawlt und nicht aufgenommen, 15 Google unbekannt.
Am 02.10. habe ich 36 Adressen über einen Einreichdienst crawlen lassen. Das hat funktioniert, und zwar so weit, wie Google es beschreibt: Um 04:15 und 04:58 UTC kamen die Abrufe, am Nachmittag standen 26 von 32 geprüften Adressen im Index. Am nächsten Morgen um 05:40 UTC war es wieder eine von 39. 33 waren „gecrawlt, zurzeit nicht indexiert“, fünf unbekannt. Der Dienst hat den Abruf geliefert. Die Bewertung danach hat Google gemacht, binnen eines Tages und ohne neuen Crawl.
Zwei Dinge lese ich daraus. Google bewertet hier nicht einzelne Seiten, sondern die Domain: Dieselben Beiträge, die am 06.09. im Index standen, sind am 03.10. draußen, ohne dass sich an ihrem Text etwas geändert hätte. Und ich habe mir das zum Teil selbst eingebrockt. Fünf Richtungswechsel bei index, noindex und Weiterleitung für jeweils 30 bis 80 Adressen in 18 Tagen sind für Google eine Seite, deren Betreiber nicht weiß, was indexiert sein soll. Dazu kommt, dass Google die Aufräumarbeiten noch gar nicht gesehen hat: Die alten, inzwischen umgeleiteten Adressen wurden laut Inspection zuletzt am 06.09. und am 20.08. gecrawlt. Für Google existieren sie noch, mit Status 200.
Was ich daraus mache, steht in Warum Google deine Seiten nicht indexiert: nichts mehr umstellen, Google die Weiterleitungen und das noindex nachcrawlen lassen und in Wochen messen, nicht in Tagen.
Was nicht hilft#
Dieselbe Adresse mehrfach zu beantragen beschleunigt nichts. Google schreibt es in die Anleitung: „eine URL nicht schneller gecrawlt wird, wenn du dafür mehrere Anfragen auf erneutes Crawlen stellst". Es verbraucht Kontingent und ändert nichts an der Reihenfolge.
Wer bei „Gecrawlt – zurzeit nicht indexiert" erneut einreicht, wartet umsonst. Google hat die Seite gelesen und entschieden; die Doku zum Bericht sagt für diesen Status: „Sie brauchen diese URL nicht noch einmal zum Crawling einzureichen." Was dann hilft, ist eine Änderung an der Seite oder an der Domain.
Die Indexing API scheidet für normale Seiten aus. Sie ist ausdrücklich beschränkt: „The Indexing API can only be used to crawl pages with either JobPosting or BroadcastEvent embedded in a VideoObject." Ein Blogbeitrag gehört nicht dazu.
Einreichdienste, die Crawls verkaufen, liefern das, was sie versprechen: einen Abruf. Der Crawl lässt sich auslösen, die Bewertung danach nicht. An der eigenen Domain sah das am 02.10.2026 so aus: 36 erzwungene Abrufe am Morgen, 26 von 32 Adressen am Nachmittag im Index, am nächsten Morgen noch eine. Den Rest entscheidet Google, über die Domain, nicht über den Klick.
Und den Text zu ändern, solange die Seite „Gefunden – zurzeit nicht indexiert" ist, bringt nichts: Google hat ihn nie gelesen. Die Änderung wird beim ersten Crawl mitgenommen, aber der Crawl kommt deshalb nicht früher.
Wie oft Google überhaupt vorbeikommt#
Die Antwort steht an drei Stellen, und die letzte ist die genaueste.
Der Überblick steht in der Search Console unter Einstellungen, Crawling-Statistik: wie viele Anfragen Google in den letzten 90 Tagen gestellt hat, wie viele Daten dabei geflossen sind, wie lange der Server im Schnitt gebraucht hat, aufgeschlüsselt nach Dateityp, Zweck und Antwortcode. Der Zweck ist das interessanteste Feld. „Aktualisieren" heißt, dass Google bekannte Adressen nachsieht, „Erkennung" heißt, dass es neue sucht. Steht die Erkennung bei null, findet Google gerade nichts Neues auf der Seite.
Für eine einzelne Adresse nennt die URL-Prüfung das Datum des letzten Crawls.
Im Server-Protokoll steht es exakt: jede Anfrage mit Zeitstempel, Adresse und Antwortcode. Das ist die einzige Quelle, die zeigt, welche Seiten wie oft abgerufen werden, und dort finden sich die Überraschungen.
Der Fehler, der die Frequenz frisst#
Nicht zu wenig Zuwendung, sondern zu viele Adressen, die sie verbrauchen. Filter- und Sortier-Adressen in Shops, interne Suchergebnisse, Kalenderseiten, die endlos in die Zukunft laufen, Schlagwortarchive mit je einem Beitrag: Jede davon wird abgerufen, und keine davon sucht jemand. Im Server-Protokoll stehen dann tausende Abrufe von Parameter-Adressen und ein paar Dutzend von den Seiten, auf die es ankommt.
Die Gegenmittel sind unspektakulär: in der robots.txt sperren, was nicht gecrawlt werden soll; Adressen mit Parametern auf die parameterfreie Fassung kanonisieren; dünne Archive aus dem Index nehmen.
Häufiges Crawling ist dabei kein Ranking-Signal. Es bedeutet, dass Google nachsieht, nicht dass es die Seite gut findet. Eine Seite kann täglich besucht und trotzdem nicht indexiert werden, und es gibt keinen Vorteil darin, dass ein Bot öfter vorbeikommt. Der Vorteil liegt darin, dass er die richtigen Seiten findet.
In Wochen messen, nicht in Tagen#
Die Dauer ist ein Symptom. Ob eine Seite in Stunden oder in Wochen aufgenommen wird, sagt wenig darüber, ob sie drin bleibt. Das misst man mit zwei vollständigen Prüfungen im Abstand von Wochen, nicht mit der Stoppuhr. Wer wissen will, ob eine bestimmte Seite drin ist, schlägt sie in der URL-Prüfung der Search Console nach. Wer sie im Bericht mit einem der vier Gründe wiederfindet, liest weiter unter Warum Google deine Seiten nicht indexiert. Dort steht, welcher der vier sich durch Warten löst und welcher nicht.
Häufige Fragen#
Wie lange dauert es, bis Google eine neue Seite indexiert?
Nach einem Antrag über die URL-Prüfung nennt Google für die Indexierung „normalerweise nur einen Tag“, an anderer Stelle ein bis zwei Wochen; das Crawling selbst kann laut Google einige Tage oder mehrere Wochen dauern. Für eine neue Seite, die niemand beantragt hat, nennt Google keine Zahl. Die Reihenfolge ist keine Warteschlange nach Eingang, die Systeme priorisieren laut Google qualitativ hochwertige und nützliche Inhalte.
Wird eine Seite schneller indexiert, wenn man sie mehrmals einreicht?
Nein. Google schreibt ausdrücklich, dass eine URL nicht schneller gecrawlt wird, wenn man mehrere Anfragen dafür stellt; es verbraucht nur Kontingent, das kontoweit gilt. Steht die Seite auf „Gecrawlt – zurzeit nicht indexiert“, ist ein neuer Antrag ebenfalls zwecklos, weil Google sie bereits gelesen und entschieden hat.
Kann man die Indexing API für normale Seiten nutzen?
Nein. Google beschränkt die Indexing API auf Seiten mit JobPosting oder mit BroadcastEvent in einem VideoObject. Ein Blogbeitrag gehört nicht dazu.
Helfen Einreichdienste bei der Indexierung?
Sie lösen einen Crawl aus, aber keine dauerhafte Aufnahme. An cyberscale.io brachten 36 erzwungene Abrufe am 02.10.2026 am Nachmittag 26 von 32 geprüften Adressen in den Index, am nächsten Morgen stand wieder nur eine darin. Die Bewertung nach dem Abruf macht Google, und zwar über die Domain.
Wann sollte man prüfen, ob eine Seite indexiert ist?
Nach zwei Wochen, nicht nach zwei Tagen, in der URL-Prüfung der Search Console und mit Blick auf das Datum des letzten Crawls. Fehlt das Datum, ist die Seite noch nicht entdeckt, und sie braucht Verweise von bereits gecrawlten Seiten. Steht ein Datum und der Status lautet „Gecrawlt – zurzeit nicht indexiert“, hilft nur eine Änderung an der Seite oder an der Domain.
Stand 03.10.2026. Quellen abgerufen und die eigene Domain am selben Tag gemessen.
Quellen (10)
- Erneutes Crawlen deiner URLs durch Google beantragen: „Das Crawling kann einige Tage oder mehrere Wochen dauern." / „eine URL nicht schneller gecrawlt wird, wenn du dafür mehrere Anfragen auf erneutes Crawlen stellst" / „Eine Crawling-Anfrage ist keine Garantie dafür, dass die Seite sofort oder überhaupt in die Suchergebnisse aufgenommen wird." / „Unsere Systeme priorisieren allerdings die Indexierung qualitativ hochwertiger und nützlicher Inhalte."
- URL-Prüftool: „Die Indexierung kann ein bis zwei Wochen dauern." / „Die Indexierung dauert normalerweise nur einen Tag, in manchen Fällen aber auch länger." / „Das Einreichen einer Anfrage garantiert nicht, dass die Seite im Google-Index erscheint." / „Wenn Sie viele Seiten indexieren möchten, reichen Sie eine Sitemap bei Google ein."
- So funktioniert die Google Suche: Entdeckung über Links „von einer bekannten Seite" und Sitemaps; „Der Googlebot bestimmt anhand eines algorithmischen Prozesses, welche Websites wann und wie oft durchsucht … werden"; „HTTP-Fehler 500 bedeuten ‚langsamer'"; „Die Indexierung wird nicht garantiert"
- Bericht „Seitenindexierung": „Gefunden – zurzeit nicht indexiert": „hat Google normalerweise versucht, die URL zu crawlen, aber das hätte die Website überlastet"; „Gecrawlt – zurzeit nicht indexiert": „Sie brauchen diese URL nicht noch einmal zum Crawling einzureichen."
- SEO-Startleitfaden: „Google findet Seiten hauptsächlich über Links von anderen bereits gecrawlten Seiten."; „innerhalb weniger Stunden … mehrere Monate"; „einige Wochen warten"
- Sitemaps: „Wir können jedoch nicht garantieren, dass alle Elemente in deiner Sitemap gecrawlt und indexiert werden."
- Sitemaps erstellen und einreichen: „Google verwendet den Wert
<lastmod>, wenn er konsistent und nachweisbar korrekt ist"; „Google ignoriert die Werte<priority>und<changefreq>." - Crawling-Budget optimieren: Kapazitätslimit sinkt, wenn „die Latenz steigt oder die Antwortzeiten länger werden"; „URLs, die im Internet beliebter sind, werden tendenziell häufiger gecrawlt"; Zielgruppe ab 10.000 Seiten mit täglichen Änderungen
- Indexing API: Kurzanleitung: „can only be used to crawl pages with either
JobPostingorBroadcastEventembedded in aVideoObject" - Eigene Messung mit der URL-Inspection-API der Search Console für cyberscale.io: 06.09.2026 (133 Adressen, vier Läufe), 01.10.2026 05:26 UTC (73), 02.10.2026 nachmittags (32 geprüfte Adressen nach 36 erzwungenen Crawls um 04:15 und 04:58 UTC), 03.10.2026 05:40 UTC (39); Bericht „Seitenindexierung“, Export vom 26.09.2026 (44 Seiten am 04.09., 170 am 05.09., 173 am 21.09.)
Weiterlesen
Kommentare
Gespeichert werden nur dein Name und dein Text — keine E-Mail-Adresse, keine IP-Adresse, kein Cookie. Jeder Kommentar wird vor der Veröffentlichung gelesen; das dauert meist einen Tag. Näheres in der Datenschutzerklärung.