Warum Google deine Seiten nicht indexiert: vier Ursachen
Steht im Bericht „Seitenindexierung" bei deiner Adresse „Gefunden" oder „Gecrawlt"? Das ist die Weiche. „Gefunden – zurzeit nicht indexiert" heißt: Google kennt die Adresse und hat sie noch nicht abgerufen; dagegen helfen Verweise, die Sitemap und ein Antrag. „Gecrawlt – zurzeit nicht indexiert" heißt: Google hat gelesen und sich dagegen entschieden; dagegen hilft nur eine Änderung an der Seite oder an der Domain, kein zweiter Antrag. Dazu kommen zwei Meldungen mit technischer Ursache, das falsche Canonical und das ungewollte noindex. Vier Meldungen, vier Probleme, und nur eines davon löst der Knopf „Indexierung beantragen".
| Meldung | Was Google getan hat | Was hilft | Hilft der Antrag? |
|---|---|---|---|
| Gefunden – zurzeit nicht indexiert | Adresse bekannt, nie abgerufen | Verweise, Sitemap | ja |
| Gecrawlt – zurzeit nicht indexiert | abgerufen, gelesen, abgelehnt | Seite oder Domain ändern | nein |
| Duplikat, andere Seite kanonisch | zwei Adressen, Google wählt die andere | Canonical, 301, interne Verweise | nein |
| Durch noindex-Tag ausgeschlossen | die Seite sagt selbst nein | das noindex entfernen | nein |
„Gefunden – zurzeit nicht indexiert"#
Google kennt die Adresse, hat die Seite aber nie abgerufen. Sie steht in der Warteschlange, und die Warteschlange ist lang. Woran das liegt: an der Priorität, die deine Domain hat. Google crawlt nicht alles, was es kennt, sondern das, wofür sich der Abruf lohnt. Bei jungen Domains ohne eingehende Verweise ist dieses Budget klein.
Was hilft, ist Auffindbarkeit: eine Sitemap, die tatsächlich eingereicht ist, und zwar die aktuelle; interne Verweise von den Seiten, die Google bereits regelmäßig besucht. Und hier wirkt „Indexierung beantragen", weil die Seite dadurch in eine bevorzugte Warteschlange rutscht. Den Text zu ändern bringt dagegen nichts. Google hat ihn nie gelesen.

„Gecrawlt – zurzeit nicht indexiert"#
Google hat die Seite abgerufen, gelesen und sich dagegen entschieden. Das ist die unbequemste der vier Meldungen, weil sie ein Urteil ist und keine Warteschlange. Und sie ist die, bei der am häufigsten das Falsche getan wird: Wer hier erneut die Indexierung beantragt, schickt dieselbe Seite noch einmal an jemanden, der sie bereits abgelehnt hat.
Woran es liegt, in dieser Reihenfolge:
Die Domain steht für nichts Bestimmtes. Wenn ein Auftritt Beiträge über Programmiersprachen, WordPress-Umzüge, Growth Hacking und Datenschutz mischt, ist für Google nicht erkennbar, wofür er die verlässliche Quelle sein soll. Ein junger Auftritt bekommt kein Vertrauen für alles gleichzeitig.
Der Beitrag ist austauschbar. Ein Text über ein Standardthema, den es tausendfach gibt, muss einen Grund liefern, ausgerechnet diesen zu nehmen: eigene Messwerte, eigene Erfahrung, ein Werkzeug daneben.
Es fehlen externe Signale. Ohne einen einzigen Verweis von außen bewertet Google konservativ, und konservativ heißt: nicht aufnehmen.
Was hilft, ist eine echte Änderung. Dünne Beiträge zu einem starken zusammenlegen. Themen ausdünnen, die nicht zum Kern gehören; auf noindex setzen kostet nichts, solange die Seiten ohnehin nicht ranken. Und dem Rest etwas mitgeben, das nur bei dir steht.
„Duplikat – Google hat eine andere Seite als kanonisch bestimmt"#
Google hält eine andere Adresse für das Original. Meist steht dieselbe Seite unter mehreren Adressen: mit und ohne www, mit und ohne Schrägstrich, unter einer Subdomain und im Unterverzeichnis, mit Parametern für Filter oder Kampagnen. Besonders häufig nach einem Umzug: Der alte Auftritt läuft noch, der neue steht schon, beide sind erreichbar, und Google entscheidet sich für den mit der längeren Geschichte.
Was hilft, ist Eindeutigkeit. Ein canonical auf jeder Seite, das auf sich selbst zeigt. Eine 301-Weiterleitung von jeder Zweitadresse auf das Original. Interne Verweise ausschließlich auf die kanonische Fassung; es hilft wenig, per canonical auf www zu zeigen und dann in hundert Beiträgen die Subdomain zu verlinken. Der Prüfschritt, den fast alle auslassen: Ruf deine Startseite in allen vier Schreibweisen auf. Drei davon sollten mit 301 auf die vierte zeigen. Das SEO-Audit prüft das mit.
„Durch ‚noindex'-Tag ausgeschlossen"#
Die Seite sagt Google selbst, dass sie nicht in den Index soll. Entweder ist das gewollt, bei Dankeseiten, internen Übersichten, ausgedünnten Altbeständen. Oder es ist ein Unfall: Ein noindex, das aus der Entwicklungsphase stehen geblieben ist, kostet nichts an Sichtbarkeit, bis jemand nachsieht.
Der zweite Unfall ist die Kombination aus noindex und einer Sperre in der robots.txt. Was der Crawler nicht abrufen darf, kann er auch nicht lesen: Er sieht das noindex nie und nimmt die Adresse trotzdem auf, nur ohne Inhalt. Erst crawlen lassen, dann nicht indexieren, in dieser Reihenfolge.
Was ich an der eigenen Domain gemessen habe#
In eigener Sache: cyberscale.io ist die Domain dieses Magazins. Am 06.09.2026 habe ich alle 134 Adressen der eigenen Sitemap einzeln über die URL-Inspection-API der Search Console abgefragt, vollständig und nicht als Stichprobe. Der Anlass war eine Vermutung, die sich als falsch herausstellte, und das ist der eigentliche Ertrag.
Vier Läufe an einem Nachmittag, dieselben 134 Adressen:
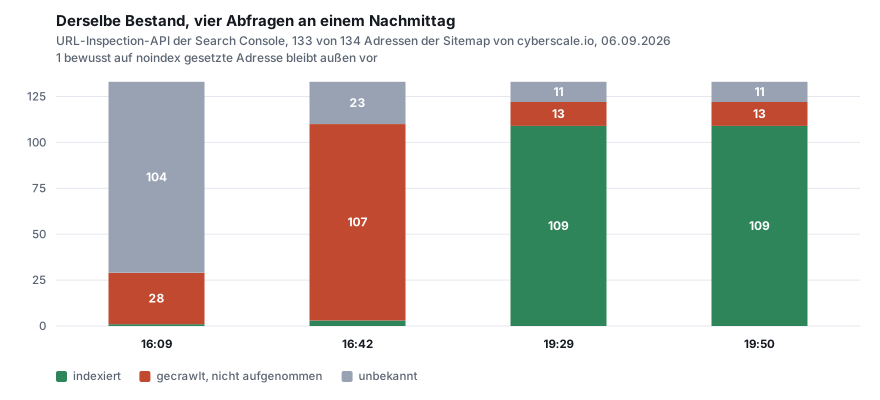
| Uhrzeit | indexiert | gecrawlt, nicht aufgenommen | unbekannt |
|---|---|---|---|
| 16:09 | 1 | 28 | 104 |
| 16:42 | 3 | 107 | 23 |
| 19:29 | 109 | 13 | 11 |
| 19:50 | 109 | 13 | 11 |
Drei Dinge stehen darin, die man aus einer einzelnen Abfrage nicht lernt.
Zwei Stichproben hatten mich in die falsche Richtung geschickt. Aus zwei geprüften Adressen hatte ich geschlossen, Google habe außer der Startseite nichts gecrawlt und die Sitemap sei schlicht zu jung. Über alle 134 gemessen stimmte beides nicht: Die Crawls reichten drei Wochen zurück, und 28 Seiten waren gelesen und abgelehnt worden. Das ist ein anderer Befund mit einer anderen Konsequenz, denn Warten hilft bei Abgelehnten nicht.
Die Antwort der API schwankt. Zwischen 16:09 und 16:42 sprang die Zahl der „gecrawlt, nicht aufgenommen" von 28 auf 107, um bis 19:29 auf 13 zu fallen. Wer um 16:42 gemessen hätte, hätte eine Katastrophe diagnostiziert; wer um 19:29 misst, sieht eine gesunde Domain. Eine einzelne Ablesung ist eine Momentaufnahme, kein Urteil, auch wenn die Meldung wie eines klingt. Erst zwei Läufe im Abstand von Wochen sagen etwas über eine Richtung.
Was den Sprung ausgelöst hat, weiß ich nicht. Zwischen den Läufen ist mehr als eine Änderung passiert, und die API nennt den Zustand, nicht den Grund; den gibt es bei Google nicht als Feld. Alles, was ich hier über Ursachen sagen könnte, wäre eine Vermutung mit einer Zahl davor.
Praktisch heißt das: Wenn du nur eine Handvoll Adressen prüfst und daraus auf die ganze Domain schließt, prüfst du zu wenig. Das Tageskontingent der API liegt bei 2.000 Abfragen je Property; ein vollständiger Lauf über einen mittleren Auftritt kostet einen Bruchteil davon.
Vier Wochen später#
Oben steht, dass erst zwei Läufe im Abstand von Wochen eine Richtung zeigen. Hier sind sie, dieselbe Domain, dieselbe API:
| Lauf | Adressen in der Sitemap | indexiert | gecrawlt, nicht aufgenommen | unbekannt |
|---|---|---|---|---|
| 06.09.2026, 19:50 | 133 | 109 | 13 | 11 |
| 01.10.2026, 05:26 UTC | 73 | 1 | 57 | 15 |
| 03.10.2026, 05:40 UTC | 39 | 1 | 33 | 5 |
Die Sitemap ist zwischen den Läufen kleiner geworden, weil ich Beiträge bewusst auf noindex gesetzt habe; die Grafik rechnet deshalb in Anteilen. Am 06.09. waren 82 % der Adressen im Index, am 01.10. und 03.10. eine einzige, die Startseite. Alles andere steht unter „Gecrawlt – zurzeit nicht indexiert“. Das ist die Meldung aus dem zweiten Abschnitt dieses Beitrags, und sie trifft jetzt mich selbst: Google hat die Seiten gelesen und sich dagegen entschieden, und zwar bei denselben Texten, die vier Wochen vorher drin waren.
Was ich vermute, nicht weiß: Die Domain hat in neun Monaten dreimal ihr Thema gewechselt, zuletzt im September mit einem Austausch fast des gesamten Inhalts, und ich habe in 18 Tagen fünfmal die Richtung geändert, welche Adressen indexiert sein sollen. Dazu zeigt die Inspection, dass Google die alten, inzwischen umgeleiteten Adressen zuletzt am 06.09. und am 20.08. gecrawlt hat. Es bewertet die Domain also nach einem Stand, den es seit Wochen nicht mehr gibt. Keiner dieser Punkte steht als Grund in der API. Sie stehen hier, weil sie zeitlich passen, nicht weil Google sie bestätigt hätte.
Was ich daraus ableite, ist unspektakulär: nichts mehr umstellen, keine Adressen mehr einreichen, Google die Weiterleitungen und das noindex in seinem Tempo nachcrawlen lassen und Ende Oktober noch einmal vollständig messen. Nichts davon wirkt in Tagen. Eine neu eingereichte Sitemap wird verarbeitet, nicht sofort gelesen; ein noindex verschwindet erst aus dem Bericht, wenn Google die Seite wieder besucht; und eine Domain, die kein Vertrauen hat, bekommt es nicht durch einen Klick. Der nächste Lauf entscheidet, ob die Richtung stimmt.
Die Reihenfolge, in der man vorgeht#
- Zuerst technisch prüfen. Liefert die Seite eine 200? Steht ein ungewolltes
noindexdrin? Zeigt dascanonicalauf sich selbst? Ist die richtige Sitemap eingereicht, und antwortet sie überhaupt noch? Alte Sitemaps aus einer früheren Installation, die inzwischen 404 liefern, sind ein verbreiteter blinder Fleck. - Dann die Meldung lesen und einordnen. Gefunden oder gecrawlt? Das ist die Weiche.
- Bei „gefunden" die Auffindbarkeit verbessern und einzeln beantragen, aber mit Maß. Das Tageskontingent für Einzelanträge ist klein und gilt für alle Properties eines Kontos zusammen, nicht je Domain.
- Bei „gecrawlt" die Substanz verbessern. Alles andere ist Beschäftigung.
- Vollständig messen, nicht stichprobenweise, und zweimal im Abstand von Wochen, sonst ist die zweite Zahl nicht vergleichbar. Gezählt wird, was indexiert ist, nicht, was veröffentlicht ist. Die erste Zahl steigt nur, wenn du etwas richtig machst, die zweite mit jedem Beitrag.
Wie du den Stand einzeln nachschlägst, steht in Die URL-Prüfung der Search Console lesen; wann sich ein Einzelantrag lohnt, in Wie lange dauert die Google-Indexierung?.
Häufige Fragen#
Was ist der Unterschied zwischen „Gefunden – zurzeit nicht indexiert“ und „Gecrawlt – zurzeit nicht indexiert“?
„Gefunden“ heißt, Google kennt die Adresse, hat die Seite aber nie abgerufen; dagegen helfen interne Verweise, eine eingereichte Sitemap und ein Antrag. „Gecrawlt“ heißt, Google hat die Seite gelesen und sich dagegen entschieden. Das ist ein Urteil über Seite oder Domain, kein Platz in einer Warteschlange.
Hilft „Indexierung beantragen“ bei „Gecrawlt – zurzeit nicht indexiert“?
Nein. Ein zweiter Antrag schickt dieselbe Seite noch einmal an jemanden, der sie bereits abgelehnt hat. Was hilft, ist eine echte Änderung: dünne Beiträge zu einem starken zusammenlegen, Themen außerhalb des Kerns ausdünnen und dem Rest etwas mitgeben, das nur dort steht, etwa eigene Messwerte.
Was passiert, wenn eine Seite noindex hat und in der robots.txt gesperrt ist?
Dann sieht Google das noindex nie, weil der Crawler die Seite nicht abrufen darf, und kann die Adresse trotzdem aufnehmen, nur ohne Inhalt. Wer eine Seite aus dem Index haben will, lässt sie crawlen und setzt noindex, ohne sie in der robots.txt zu sperren.
Wie zuverlässig ist eine einzelne Abfrage der URL-Inspection-API?
Wenig. Bei einer Messung über 134 Adressen am 06.09.2026 sprang die Zahl der gecrawlten, nicht aufgenommenen Seiten zwischen 16:09 und 16:42 von 28 auf 107 und fiel bis 19:29 auf 13. Eine einzelne Ablesung ist eine Momentaufnahme; erst zwei vollständige Läufe im Abstand von Wochen zeigen eine Richtung.
Wie viele Adressen kann man pro Tag mit der URL-Inspection-API prüfen?
Google erlaubt 2.000 Abfragen am Tag je Property. Ein vollständiger Lauf über einen mittleren Auftritt kostet davon nur einen Bruchteil, deshalb lohnt es sich, alle Adressen der Sitemap zu prüfen statt einer Stichprobe. Getrennt davon ist das Kontingent für Einzelanträge in der Oberfläche klein und gilt für alle Properties eines Kontos zusammen.
Stand 03.10.2026. Quellen abgerufen und die eigene Domain am selben Tag gemessen.
Quellen (4)
- Aufnahme in den Google-Suchindex mit „noindex“ blockieren: „sieht der Crawler die Regel
noindexnicht und die Seite kann weiterhin in den Suchergebnissen erscheinen“ - Bericht „Seitenindexierung": die vier Meldungen und ihre Erklärungen
- Search Console API: Usage limits: URL Inspection: „Per-site quota … 2000 QPD, 600 QPM“ (abgerufen am 03.10.2026)
- Eigene Messung mit der URL-Inspection-API der Search Console für cyberscale.io: 06.09.2026 (vier Läufe über 134 Adressen, eine davon bewusst auf noindex), 01.10.2026 05:26 UTC (73 Adressen), 03.10.2026 05:40 UTC (39 Adressen)
Weiterlesen
Kommentare
Gespeichert werden nur dein Name und dein Text — keine E-Mail-Adresse, keine IP-Adresse, kein Cookie. Jeder Kommentar wird vor der Veröffentlichung gelesen; das dauert meist einen Tag. Näheres in der Datenschutzerklärung.